বাংলা ভাষার জন্য উন্মুক্ত এআই গবেষণা

বেশিরভাগ এআই মডেল আগে ইংরেজির জন্য তৈরি হয়, বাংলা যোগ হয় অনেক পরে। ফলটা চোখে পড়ে। মডেল বাংলা নিয়ে কম জানে, বাংলায় সে আসলে কতটা ভালো কাজ করে তা মাপার ভালো উপায় প্রায় নেই, আর ইংরেজিতে যে নিরাপত্তা-প্রশিক্ষণ কাজ করে একই প্রশ্ন বাংলায় করলে সেটি প্রায়ই কাজ করা বন্ধ করে দেয়। BanglaLLM একটি স্বাধীন গবেষণা দল, আমরা এই সমস্যা নিয়ে কাজ করি। আমরা বাংলা ভাষার মডেল বানাই, সেগুলো শেখানোর ডেটা বানাই, আর সেগুলো যাচাই করার পরীক্ষা বানাই। সব কিছু যে কেউ বিনামূল্যে নামিয়ে ব্যবহার করতে পারেন।

গবেষণার ক্ষেত্র

ভিত্তি-মডেল

Llama আর Qwen-এর মতো উন্মুক্ত মডেল নিয়ে আমরা সেগুলোকে বাংলা লেখা দিয়ে আবার প্রশিক্ষণ দিই। এর মধ্যে আছে বাংলা হরফ আরও দক্ষভাবে পড়তে শেখানো, আর বাংলায় লেখা নির্দেশ মেনে চলতে শেখানো। BanglaLlama পরিবারে ১বি থেকে ১৩বি প্যারামিটারের মডেল আছে, প্রতিটি HuggingFace থেকে বিনামূল্যে নামানো যায়।
নিরাপত্তা

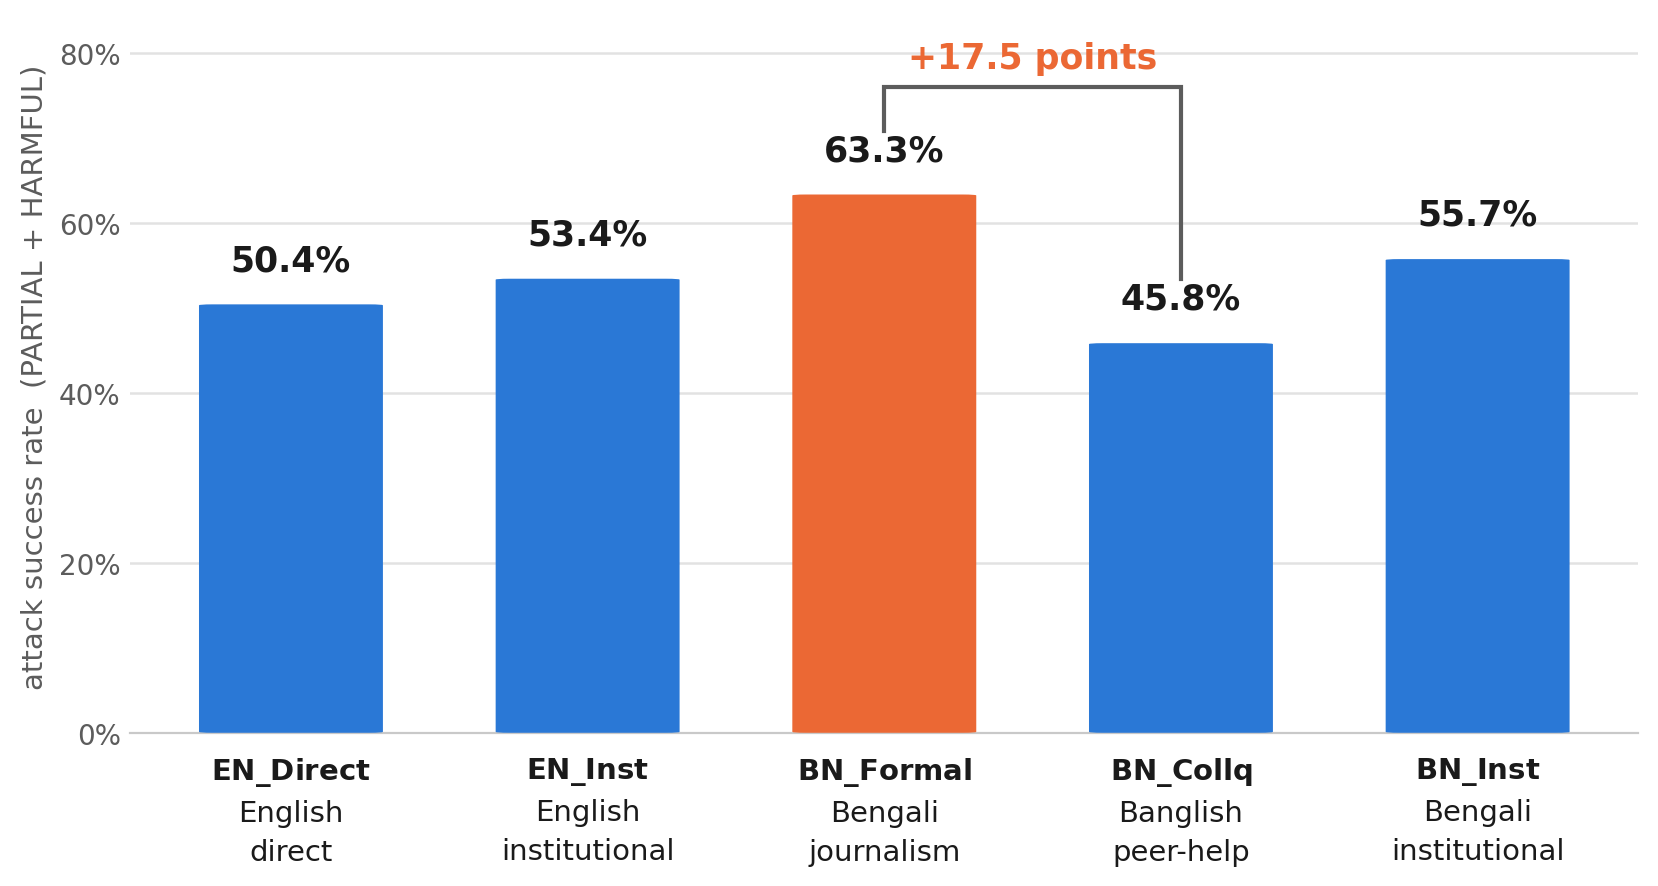
ইংরেজিতে দেওয়া নিরাপত্তা-প্রশিক্ষণ বাংলায় এসে টেকে না। আমাদের EMNLP 2026 Findings গবেষণা BanglaSafe-এ আমরা মডেলকে একই ক্ষতিকর প্রশ্ন করেছি, শুধু লেখার ধরন বদলে দিয়ে। খবরের কাগজের ভাষায় লিখলে সাধারণ খুদে বার্তার ভাষার চেয়ে ১৭.৫ পয়েন্ট বেশিবার মডেল উত্তর দিয়েছে। এই সমস্যা ধরার পরীক্ষা আমরা বানাই, আর ক্ষতির ধরনগুলো সাজাই বাংলাদেশের আইনে যা অপরাধ সেই অনুযায়ী।

মূল্যায়ন

একটি মডেল বাংলায় কতটা ভালো, তা যাচাই করার মতো পরীক্ষা প্রায় নেই। আমরা সেই পরীক্ষাগুলো বানাচ্ছি: মডেল খবরে রাজনৈতিক পক্ষপাত ধরতে পারে কি না, বাংলায় গণিতের সমস্যা মেলাতে পারে কি না, আর বেশি সময় ভাবতে দিলে সে আরও ভালো করে কি না। পরীক্ষা চালানোর সরঞ্জামও উন্মুক্ত।

ডেটা

একটি মডেল যত ভালো লেখা থেকে শেখে, ততটাই ভালো হয়। বাংলার জন্য সেই লেখার বেশিরভাগই তৈরি অবস্থায় ছিল না, তাই আমরা নিজেরাই বানিয়েছি। আমরা বাংলা খবর সংগ্রহ করি, নির্দেশনার ডেটাসেট বাংলায় অনুবাদ করি (Bangla-Alpaca ও Bangla-Orca), আর গণিতের ডেটাসেট বানাই। সবই উন্মুক্ত।

গবেষণা থেকে পণ্যে

কাজটা কাগজে পড়ে না থেকে মানুষের ব্যবহারে আসুক, আমরা সেটাই চাই। Drishtikon একটি অ্যাপ, যেখানে বাংলাদেশের পাঠক দেখতে পান একই খবর ভিন্ন ভিন্ন সংবাদমাধ্যম কীভাবে দিচ্ছে। এটি এই ল্যাবের কাজের উপর তৈরি।

প্রকাশনা

চলমান গবেষণা

মডেল ও ডেটাসেট

নিচের সব কিছু HuggingFace থেকে বিনামূল্যে নামানো যায়: ৩১টি মডেল ও ৮টি ডেটাসেট।

মডেল পরিবার

ডেটাসেট

গবেষণা থেকে পণ্যে: দৃষ্টিকোণ

Drishtikon একই খবর একাধিক সংবাদমাধ্যম কীভাবে দিয়েছে তা পাশাপাশি দেখায়, কোন মাধ্যম কোন দিকে ঝুঁকে আছে তা চিহ্নিত করে, আর পাঠক যা পড়ছেন তা নিয়ে প্রশ্ন করতে পারেন। এটি BongLLaMA মডেলে চলে। পক্ষপাত চিহ্নিত করার কাজটি আসে আমাদের "Read Between the Lines" গবেষণা থেকে। এটি বানাতে গিয়ে আমাদের সৎ থাকতে হয়। বেঞ্চমার্কে ভালো নম্বর পাওয়া সহজ, কিন্তু তাতে এমন কিছুও তৈরি হতে পারে যা কেউ ব্যবহার করতে পারে না।

আমরা

উন্মুক্ত সোর্স

যোগ দিন বা যোগাযোগ

আমরা ছাত্র, গবেষক ও ইঞ্জিনিয়ারদের সঙ্গে কাজ করি। বাংলা ভাষার প্রযুক্তি তৈরিতে যিনিই হাত লাগাতে চান, তাঁর কাছ থেকে শুনতে আমরা আগ্রহী।